前言
把一个模型拆到多张 GPU 上,可以解决单卡放不下的问题,也会带来新的等待:下游还没收到前向结果,上游还没收到反向梯度,某些 GPU 就只能空着。这些由流水线执行依赖形成的空闲,通常叫作 pipeline bubble,流水线气泡。
理解调度时,可以先追踪一个 microbatch 的前向数据与反向梯度,再观察多个 microbatch 在不同 GPU 上的执行。本文用同一个例子讲清普通 1F1B、Interleaved 1F1B、V 形调度、Zero Bubble,以及它们与 Megatron 的关系。
先记住四个动作:
1F1B 提前回收激活;
Interleaved 把任务切小;
V 形布局重新搭配模型分段;
Zero Bubble 把可延后的参数梯度计算填进空槽。
参数更新在多张 GPU 上的执行流程
假设一个模型有 32 层,单卡放不下,于是把它平均分给 4 张 GPU。GPU 0 保存第 1 至 8 层,GPU 1 保存第 9 至 16 层,后两张依次类推。每一段叫作一个 stage,流水线阶段。这些 GPU 共同保存并执行一份完整模型。
输入先经过 GPU 0,GPU 0 把中间结果发给 GPU 1,最后在 GPU 3 计算 loss。反向传播沿相反方向走:后一段算出梯度,发给前一段,让前一段继续反传。
前向是把输入变成预测结果的过程,loss 是衡量预测与目标差距的数值。反向根据 loss 计算梯度,optimizer 再利用参数梯度调整权重。刚接触反向传播时,可以先把梯度理解成沿模型倒着传递的调整信号。
| 训练中的量 | 含义 | 与流水线的关系 |
|---|---|---|
| 参数 | 各层的权重,同一个同步 step 中由多个 microbatch 共享 | 每张 GPU 只保存自己负责的模型分段 |
| 激活 | 某份数据前向时产生的中间结果 | 反向还要使用,通常需要暂存,决定一部分显存占用 |
| 梯度 | loss 对输入或参数变化的敏感程度 | 输入梯度传给前一 stage;参数梯度累积后用于更新 |
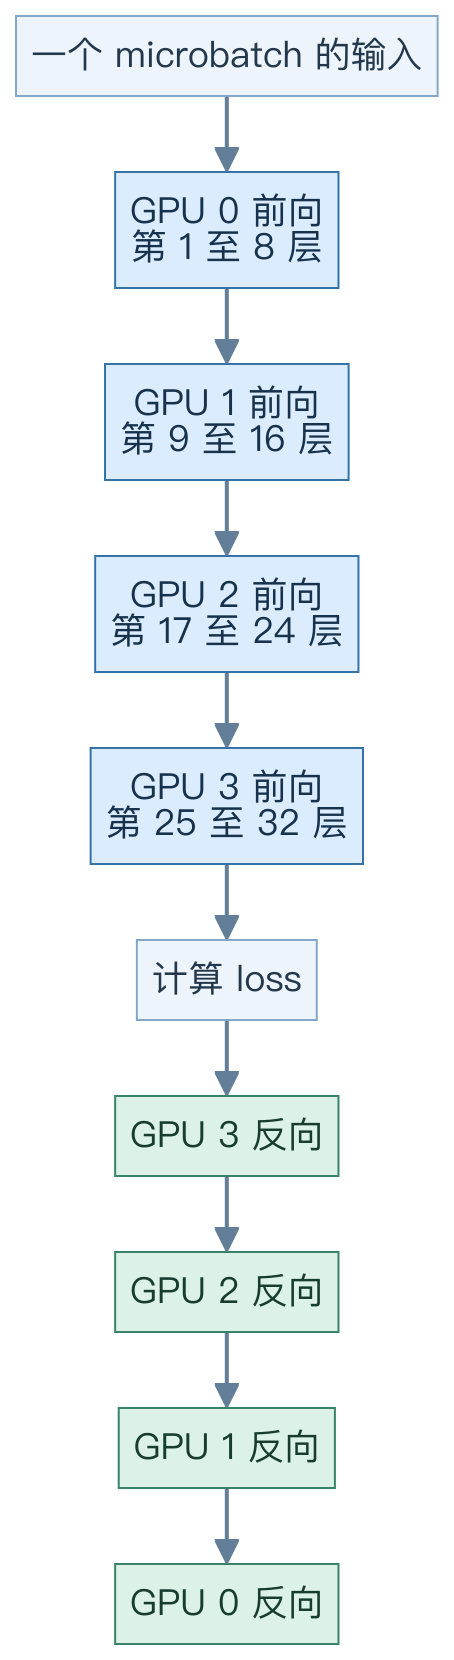
图 1:沿同一个 microbatch 追踪前向和反向。箭头表示计算依赖:后层前向完成后计算 loss,前层收到后层梯度后执行反向。
如果只让一个 microbatch 走完整条路径,再处理下一个,大多数时间只有一张 GPU 工作。流水线并行要让不同 GPU 同时处理不同 microbatch,才能提高利用率。
这里有四个容易混淆的词:
| 名称 | 在这个例子中的含义 |
|---|---|
| GPU 或物理 PP rank | 实际执行计算的设备,一共 4 个 |
| stage 或 model chunk | 模型的一段;后面会看到一张 GPU 可以持有多个 chunk |
| microbatch | 一次送入流水线的小批数据;同一份数据要走完所有 stage |
| optimizer step | 多个 microbatch 完成梯度累积后,进行一次参数更新 |
PP 将模型分布到 4 张 GPU,同一份 microbatch 依次经过各个 stage。
把大 Batch 拆成多个 Microbatch
继续使用 4 张 GPU。假设一次参数更新要处理 16 个样本,每个 microbatch 装 2 个样本,就得到 8 个 microbatch,编号为 1 至 8。
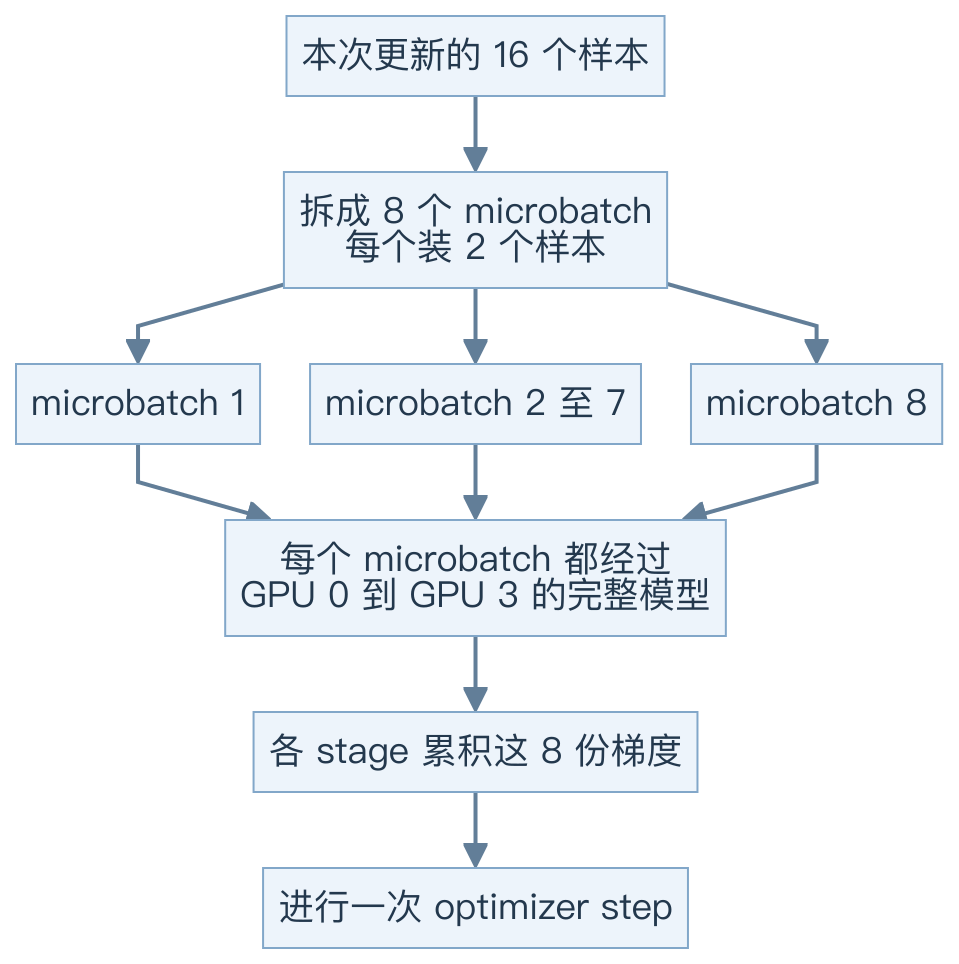
图 2:8 个 microbatch 对应一次参数更新。它们共享本步参数,梯度先累积,再更新。
当 GPU 0 把 microbatch 1 的结果交给 GPU 1 后,GPU 0 就可以开始 microbatch 2。此时 GPU 0 和 GPU 1 同时工作,但处理的是不同数据。再过一段时间,四张 GPU 都能忙起来。
为了让时间线容易对照,下面先采用一个教学模型:每个 stage 的一次前向记为 F,耗时 1 单位;一次完整反向记为 B,耗时 2 单位;同一张 GPU 同时只执行一个计算任务;暂时忽略通信、重计算和 optimizer 耗时。横轴使用教学用的相对时间。
教学模型用来解释调度依赖及空闲位置;真实训练的 F、B 时间和吞吐需要在具体负载上测量。
GPipe 的填充与排空气泡
GPipe 的顺序很直观:先把本步 8 个 microbatch 的前向全部做完,再按流水线执行反向,最后更新参数。
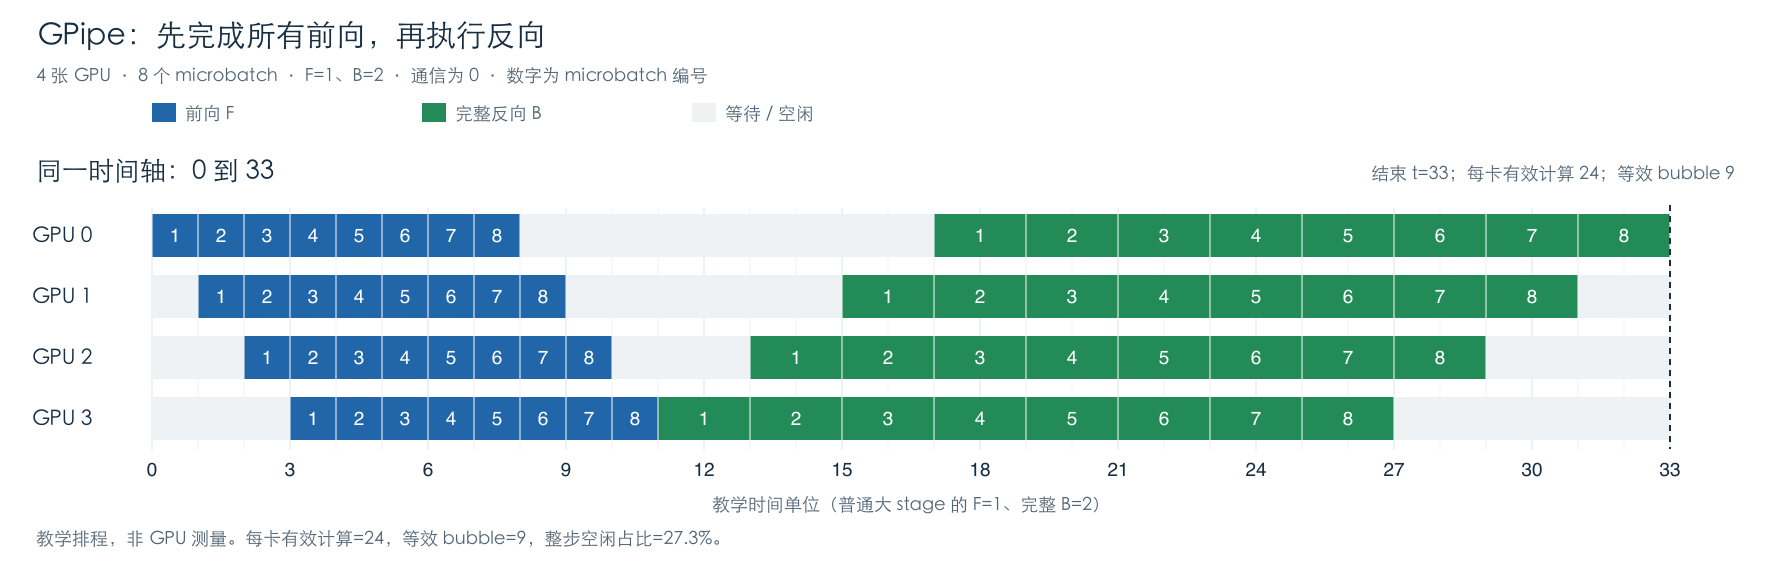
图 3:4 张 GPU、8 个 microbatch,F 为 1 单位、完整 B 为 2 单位。方块编号表示 microbatch;灰色表示该 GPU 当前没有计算任务。所有行共用一条时间轴。
读图时先看最左边。GPU 1 必须等 GPU 0 做完第一份前向,GPU 2 再等 GPU 1,GPU 3 还要再等一次。这一段叫 warm-up,填充。
再看最右边。最后一份梯度逐段传回 GPU 0 时,已经做完本段工作的 GPU 无事可做。这一段叫 cool-down 或 drain,排空。为了让下一步使用更新后的参数,同步训练需要处理本步结束时的边界。
这里的等待来自数据依赖。即使所有 GPU 算得一样快,填充和排空仍然存在。通信慢、某个 stage 算得特别久,还会增加别的等待;这些原因在后面再区分。
GPipe 还有一个显存问题:前向生成的中间激活要等到反向才能释放。本步前向先一路执行,早期 stage 会同时保留许多 microbatch 的激活。
1F1B 的提前反向与激活回收
1F1B 是 one forward one backward。在流水线填充后,每张 GPU 大致交替执行一个前向和一个反向:先接着送一份新数据向前,再处理一份已经返回的旧梯度。
先看四张 GPU 的完整时间线。蓝色是前向,绿色是反向,方块里的数字是 microbatch 编号。每一行表示一张 GPU 的工作,所有行共用同一条时间轴。
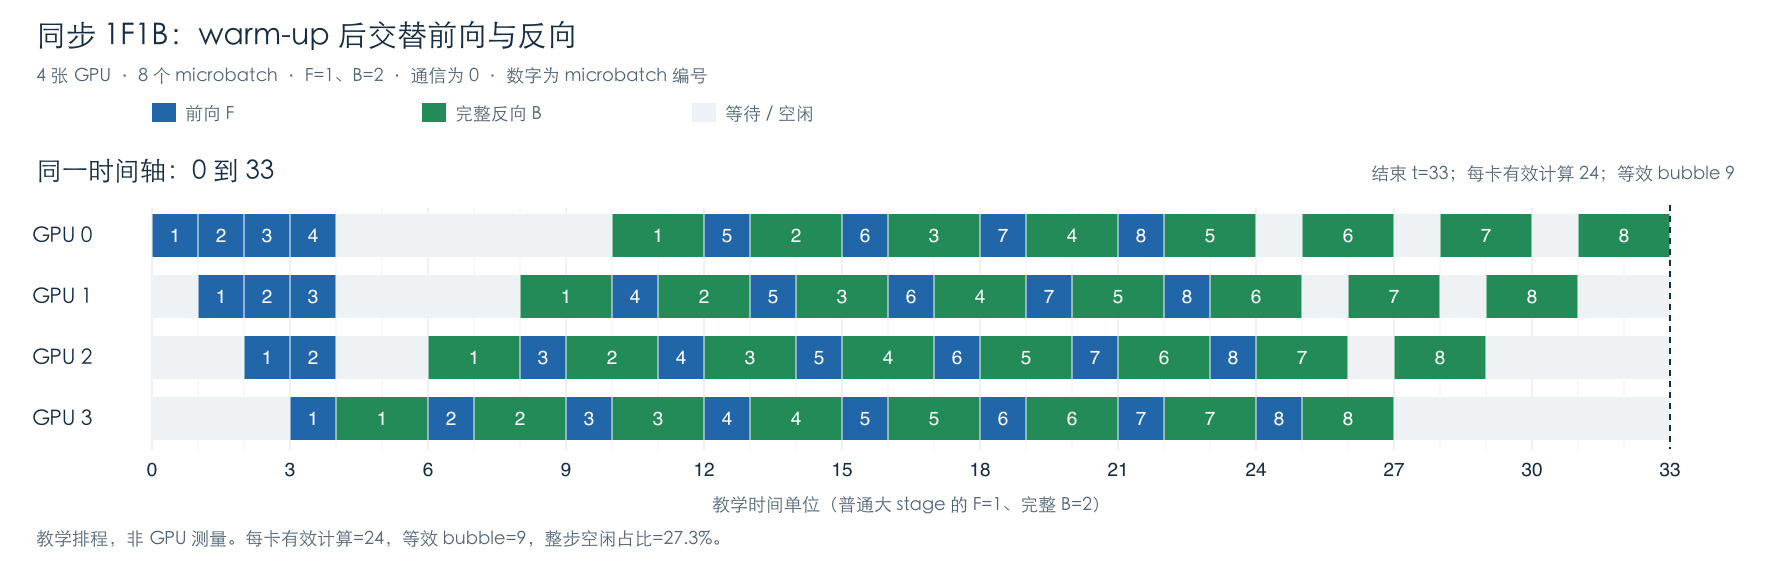
图 4:与图 3 使用相同设备数、microbatch 数和时间尺度。图中一个 F 和紧接着的 B 通常属于不同 microbatch,时间线展示了它们的交替顺序与最终结束时间。
例如,GPU 0 先执行 F1 至 F4,等待后执行 B1,再执行 F5 和 B2。F4 是 microbatch 4 的前向,B1 是 microbatch 1 的反向。
GPU 0 在 t=10 开始 B1,前提是 microbatch 1 的反向梯度已逐级传回。下面追踪这份 microbatch 在四张 GPU 之间的前向与反向。
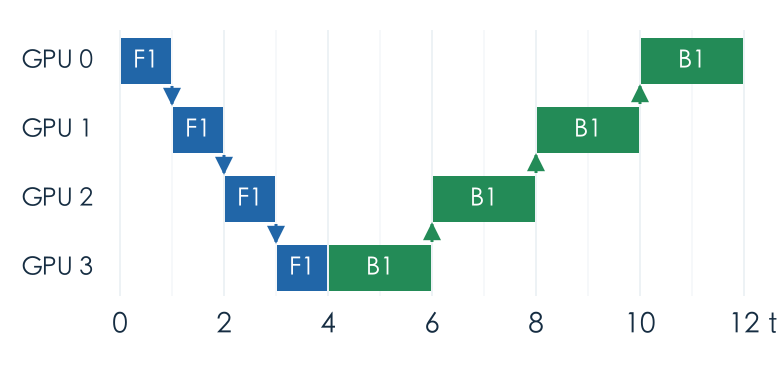
图 5-1:只画 microbatch 1。前向从 GPU 0 传到 GPU 3,反向再依次传回;空白处可能有未画出的其他 microbatch 在计算。此教学例子中 F=1、完整 B=2,通信和 loss 计算耗时均为 0。
| GPU | F1 前向 | B1 反向 | B1 完成后的结果 |
|---|---|---|---|
| GPU 3 | t=3 至 4 | t=4 至 6 | t=6 把输入梯度交给 GPU 2 |
| GPU 2 | t=2 至 3 | t=6 至 8 | t=8 把输入梯度交给 GPU 1 |
| GPU 1 | t=1 至 2 | t=8 至 10 | t=10 把输入梯度交给 GPU 0 |
| GPU 0 | t=0 至 1 | t=10 至 12 | t=12 完成 B1,释放激活 1 |
在 1F1B 中,GPU 3 完成 F1 后就开始 B1,此时本步还有其他 microbatch 的前向任务待处理。t=12 时,GPU 3 刚完成 microbatch 3 的 B3,随后开始 F4;它的 B1 在 t=6 已经结束。
再看 GPU 0 在 t=12 的激活变化:
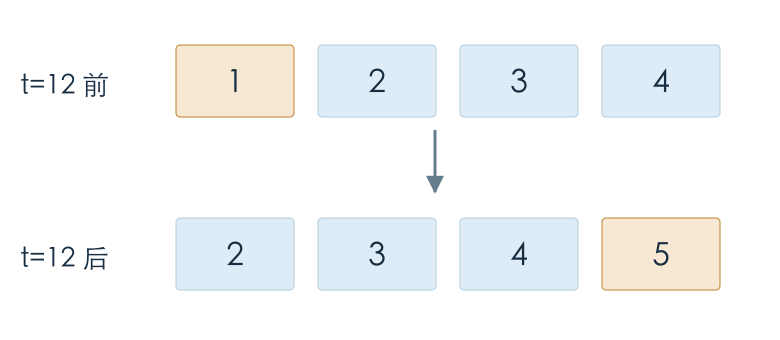
图 5-2:GPU 0 完成 B1 后释放激活 1,同时开始 F5 并分配激活 5。驻留集合从 {1,2,3,4} 变成 {2,3,4,5},份数仍为 4。
教学模型把一个 stage 的激活作为整体,在该 stage 的完整反向结束时释放;真实框架可能在反向过程中逐层回收,也可能因其他引用而保留更久。
反向提前,意味着较早用完的激活可以较早释放。把 GPU 0 上同时保留的激活份数画出来,就能看到 1F1B 的主要价值。
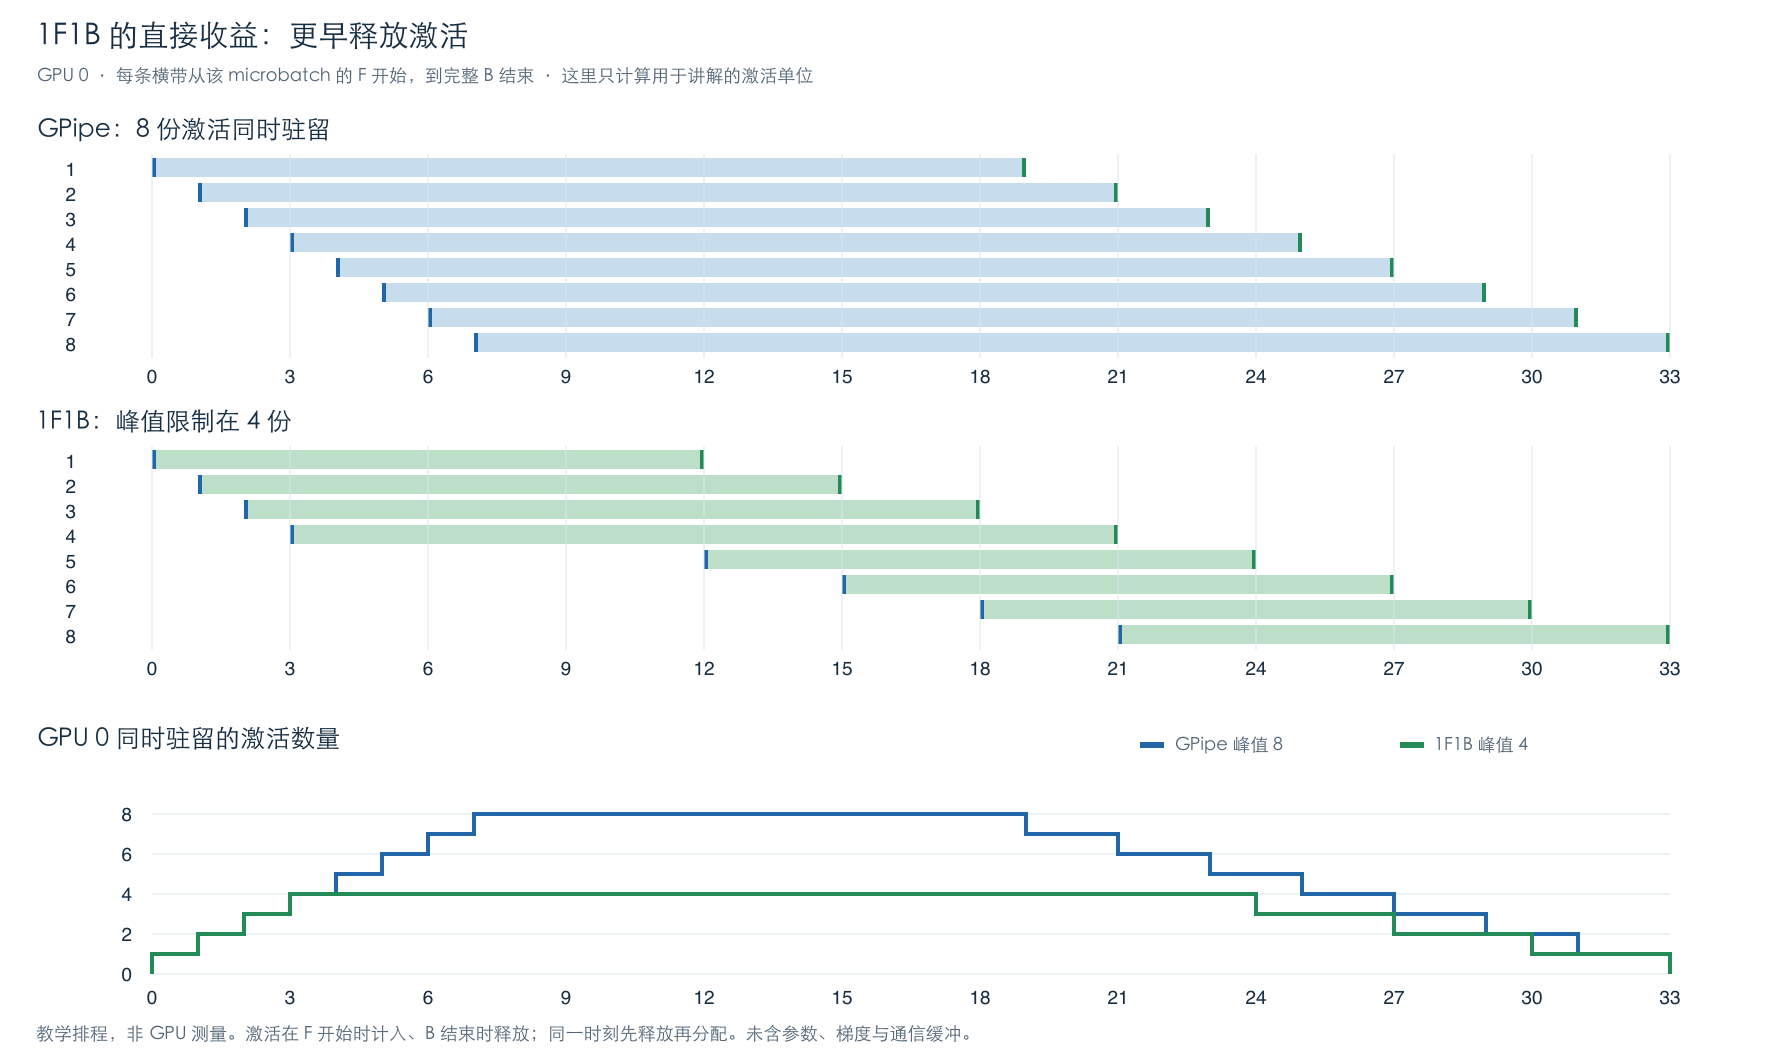
图 6:统计 GPU 0 同时保留的 microbatch 激活份数。这个教学例子中,GPipe 峰值为 8 份,1F1B 峰值为 4 份;参数、优化器状态、通信 buffer 和显存分配器开销另计。
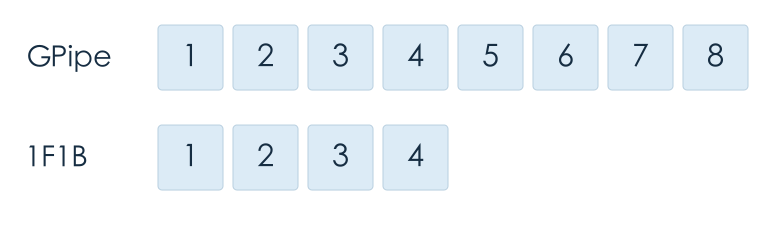
图 7:教学排程在 t=8 时 GPU 0 的激活快照。GPipe 保留 8 份,1F1B 保留 4 份;方块编号对应 microbatch。1F1B 后续仍会处理其余 microbatch。
在相同条件下,普通 1F1B 与 GPipe 的理想 bubble 时间相同。1F1B 首先改善激活回收:当 microbatch 数足够多时,峰值激活驻留数量受流水线深度限制,与本步 microbatch 总数解耦。GPipe 与 1F1B 的分析
这也解释了它与 bubble 的间接关系:显存省下来以后,更容易容纳更细的 batch 拆分或减少重计算。最终的加速效果还取决于 batch 配置和计算效率。
用一张时间账单算清 Bubble 比例
先只看一张 GPU。8 个 microbatch,每个需要 F 加 B,也就是 3 单位计算,因此这张 GPU 本步必须完成 24 单位有效工作。上面的教学排程在时间 33 结束,相比 24 多出 9 单位。
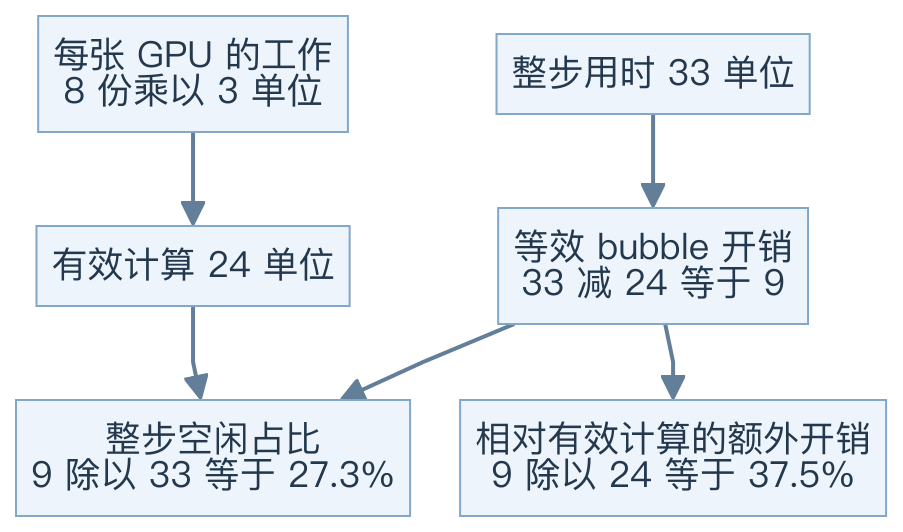
图 8:同样是 9 单位 bubble,分母不同,得到的百分比不同。
这里的 9 是相对理想整步时间增加的等效开销。四张 GPU 时间线上的灰格加起来是 36 GPU·时间单位;用它除以总资源时间 4×33,同样得到 27.3%。9 表示单次迭代的等效时间开销,36 表示四张 GPU 累计的空闲资源量。
推广到 p 张均衡 GPU、m 个 microbatch,每张 GPU 的一次前向和完整反向分别耗时 F、B:
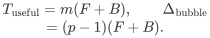
本篇将“空闲占比”固定定义为 bubble 占整步时间的比例:
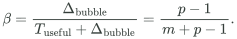
有些论文把 bubble 除以有效计算时间,写成 (p−1)/m;这是另一种口径。比较数字之前,先看分母。
在固定单 microbatch 计算成本的模型里,增加 m 会增加有效工作量,而填充排空的绝对开销仍为 (p−1)(F+B),所以降低的是空闲占比。固定 global batch 时,增加 m 通常意味着减小每个 microbatch,F、B 的耗时也会随之变化。
例如,p=4 时,m 从 8 增加到 16,空闲占比从 3/11=27.3% 降到 3/19=15.8%。实际调参需要测量更小的 microbatch 对矩阵乘法效率的影响。
Interleaved 1F1B 把时间片切小
普通划分中,每张 GPU 持有一段连续的 8 层模型。Interleaved 1F1B 先把整个 32 层模型切成 8 个连续的 4 层 chunk,再轮流分给 4 张 GPU。每张 GPU 仍共承担 8 层,但层的位置重新分配如下。
| 设备 | 普通划分 | Interleaved 划分 |
|---|---|---|
| GPU 0 | 第 1 至 8 层 | 第 1 至 4 层,以及第 17 至 20 层 |
| GPU 1 | 第 9 至 16 层 | 第 5 至 8 层,以及第 21 至 24 层 |
| GPU 2 | 第 17 至 24 层 | 第 9 至 12 层,以及第 25 至 28 层 |
| GPU 3 | 第 25 至 32 层 | 第 13 至 16 层,以及第 29 至 32 层 |
按模型先后给八个 chunk 编号 C0 至 C7,同一个 microbatch 的前向路径如下。
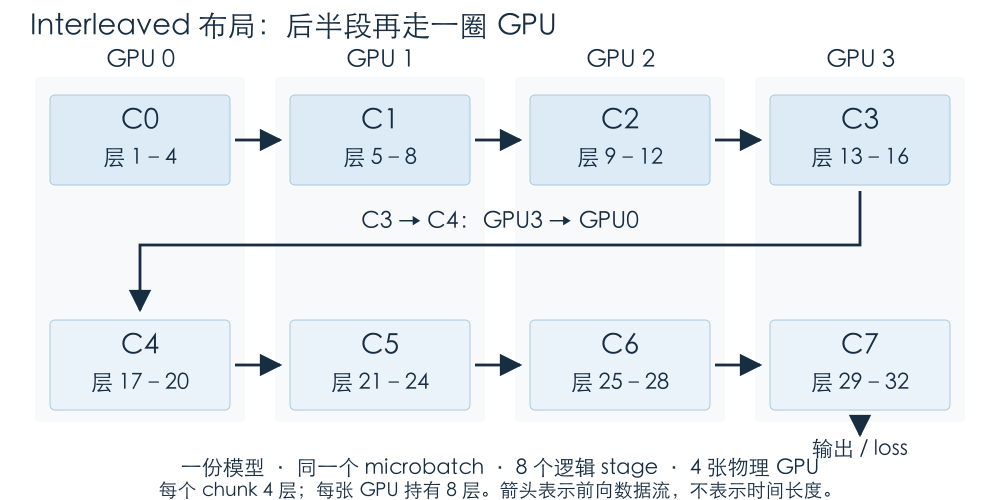
图 9:Interleaved 的模型路径。数据按 C0 至 C7 依次计算,设备顺序绕行两次。图中的上下两排依次表示同一模型的前半部分和后半部分。
一张 GPU 会在自己的两个 chunk、多个 microbatch 的前后向之间切换。虽然逻辑 stage 变多,每个 stage 的工作变短;结合交错执行,填充和排空可以用更小的时间片完成。
设每张 GPU 有 v 个均衡 chunk,每个 chunk 的 F、B 时间约为原来的 1/v,理想公式为:
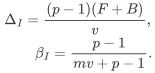
这里各 GPU 总计算量基本不变,改变的是任务大小和排列。增加的 chunk 边界使 PP 通信量约增长到 v 倍,也可能增加激活驻留和调度成本。Interleaved 1F1B 的构造与代价
把前面的四卡例子改成 v=2 后,单个 chunk 的 F 为 0.5、完整 B 为 1,每卡总有效计算仍为 24 单位。合法交错排程可以在 28.5 结束,等效 bubble 为 4.5,空闲占比为 15.8%。
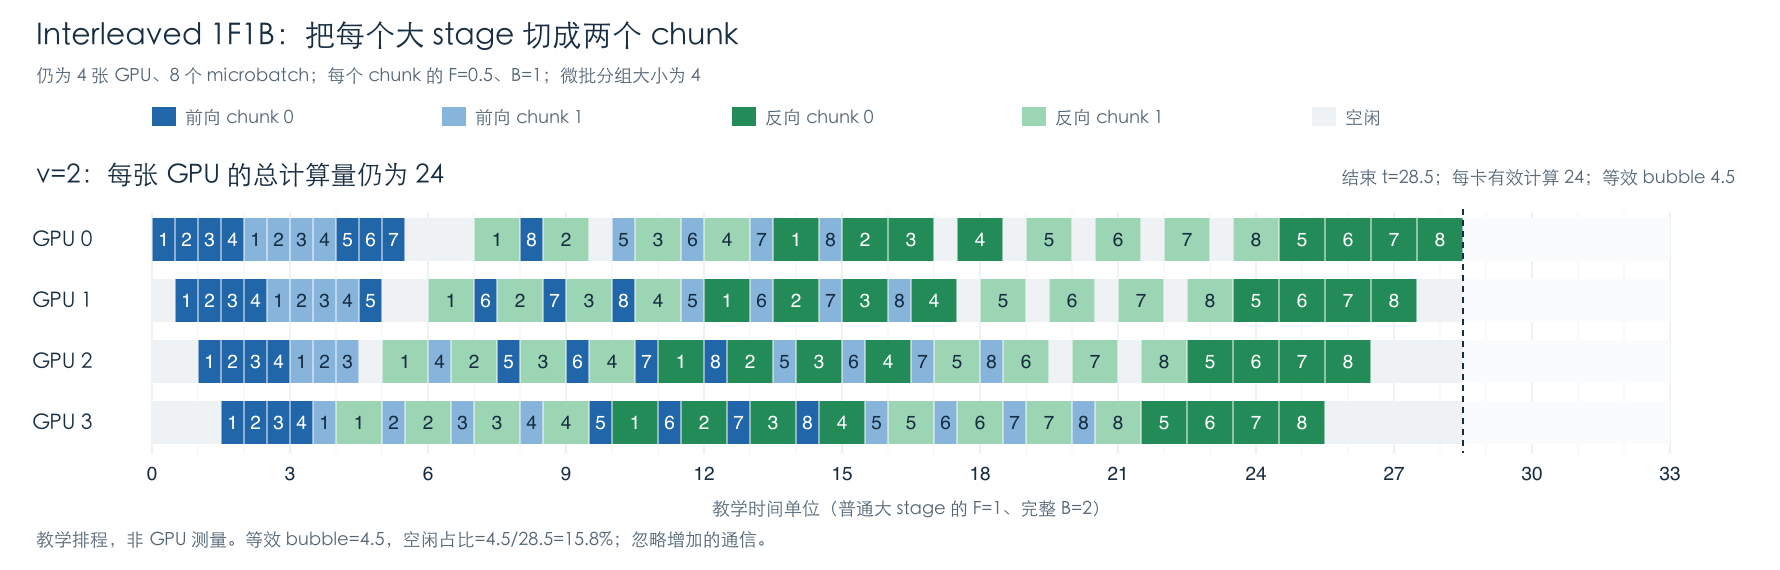
图 10:与前面的普通 1F1B 共用时间尺度。深浅区分每张 GPU 的本地第一个、第二个 chunk;图例中的 chunk 0 和 chunk 1 是本地编号,图 9 的 C0 至 C7 是全模型的编号。完整图可放大查看 microbatch 编号。
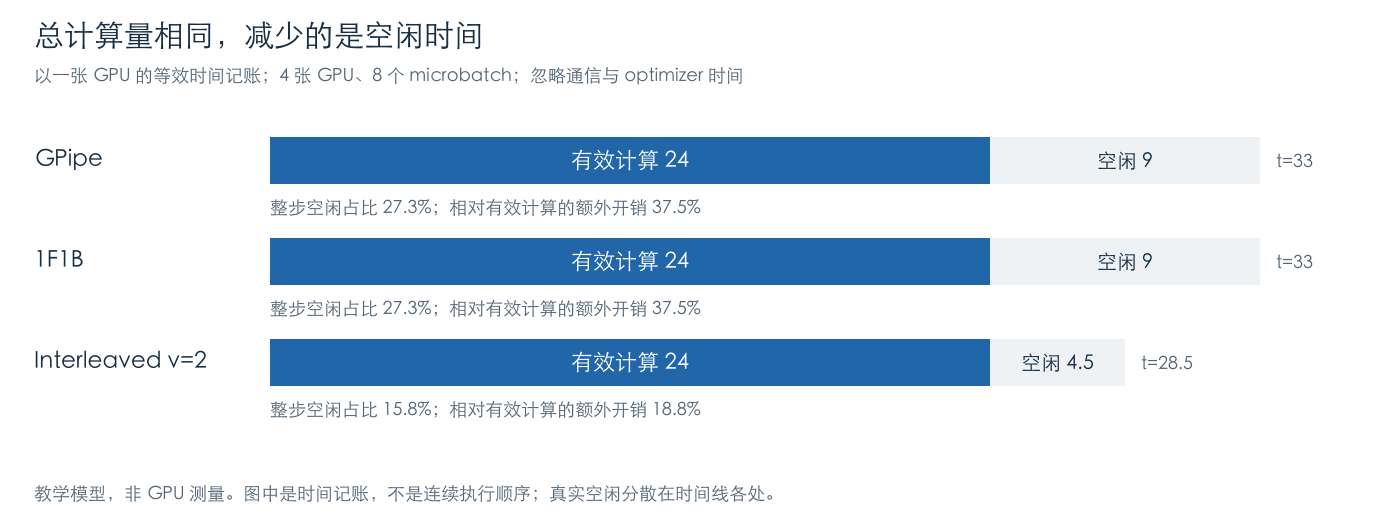
图 11:把相同的有效计算量与等效 bubble 分开记账。各处空闲按总量汇总在右侧,用于比较三种方案的有效计算和等效 bubble。
例如 p=8、m=32 时,普通 1F1B 的理想空闲占比为 17.9%;v=2 时为 9.9%,v=4 时为 5.2%。这是同一时间模型的计算值。v=2 将 bubble 时间减半,整步仍包含原有有效计算,因此整步加速幅度会小得多。
Interleaved 常写作 1F1B-I,Megatron 也称它为 VPP,虚拟流水线并行。VPP 中的 V 是 virtual。
V 形布局与激活生命周期的搭配
同样把模型切成八个 chunk,还可以让每张 GPU 持有一个靠前 chunk 和一个靠后 chunk。此时设备路径先向前走,再折返回来,形成 V 形。
| 设备 | Interleaved 布局 | V 形布局 |
|---|---|---|
| GPU 0 | C0、C4 | C0、C7 |
| GPU 1 | C1、C5 | C1、C6 |
| GPU 2 | C2、C6 | C2、C5 |
| GPU 3 | C3、C7 | C3、C4 |
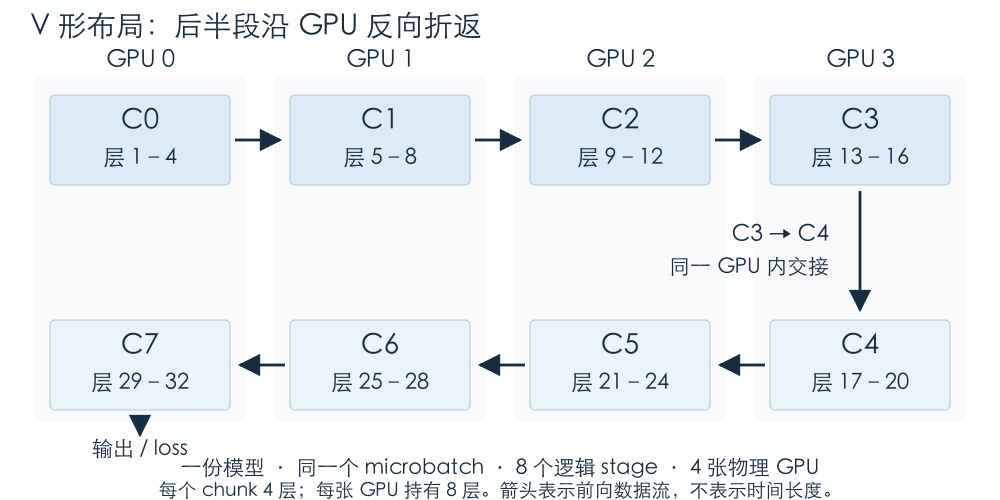
图 12:V 形布局。GPU 0 同时持有模型的开头和末尾;GPU 3 持有中间相邻的两个 chunk。图中的箭头仍表示模型顺序。
激活从前向产生,到对应反向使用完毕,期间需要保存在显存中。这段时间叫作它的 生命周期。早期 chunk 通常等得更久,后期 chunk 通常可以更早开始反向。
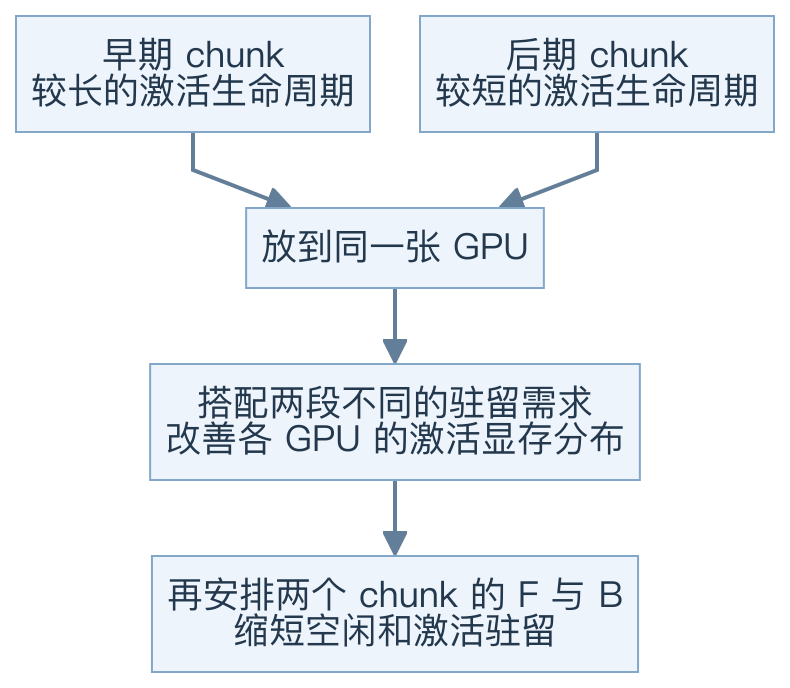
图 13:V 形布局的显存直觉。具体峰值由任务顺序和各 chunk 激活生命周期的重叠情况决定。
1F1B-V 是论文中的一个具体构造:使用 V 形布局,同时将反向作为完整 B 执行。论文给出其更低的 bubble,以及峰值激活显存渐近为普通 1F1B 的约 2/3。1F1B-V 的定义
V 形布局提供重新排程的机会。零 bubble 的实现取决于任务拆分、依赖安排和更新边界的处理。下面的 ZB-V 会在此基础上进一步拆开反向。
Zero Bubble 的反向计算拆分
完整 backward 里包含不同用途的计算。以一个线性层为例,前向为 Y=XW,收到后面传来的 dY 后,需要计算:
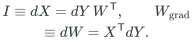
下面把输入梯度计算写作 I,参数梯度计算写作 Wgrad;两部分合并构成完整反向。部分论文用 B 表示输入梯度计算,阅读公式时需要留意符号的定义。
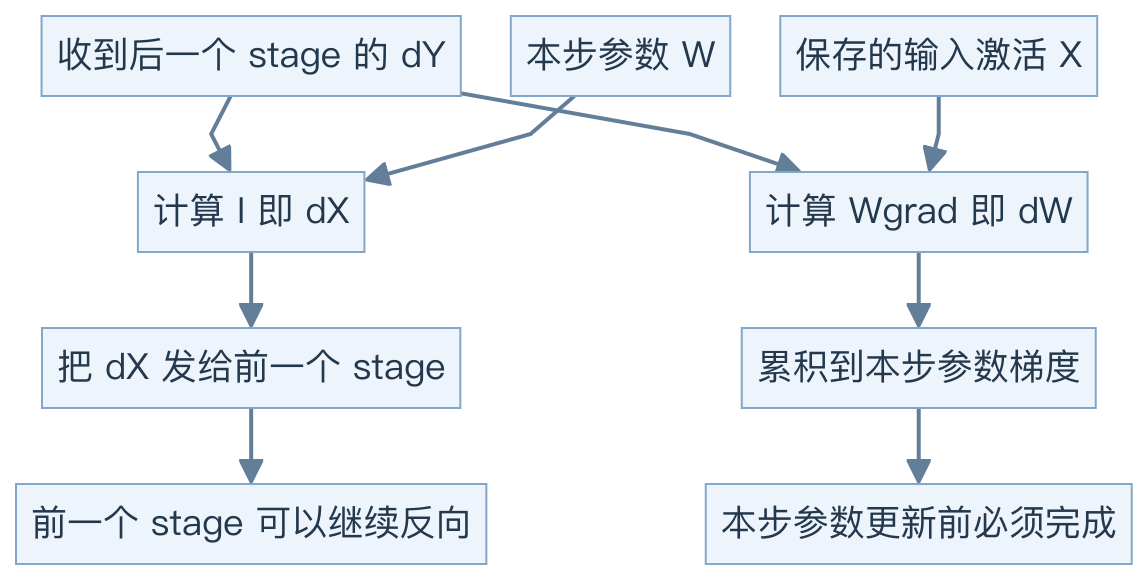
图 14:两种梯度有不同的使用者。前一个 stage 急需 dX;dW 的截止时间是本步参数更新。这里展示线性层依赖,具体网络还包含非线性和其他算子。
如果把 I 与 Wgrad 捆在一起执行,再向上游交付结果,上游可能多等一段参数梯度计算。拆开以后,可以先交付 dX,再把 Wgrad 放进暂时没有其他任务的空槽。
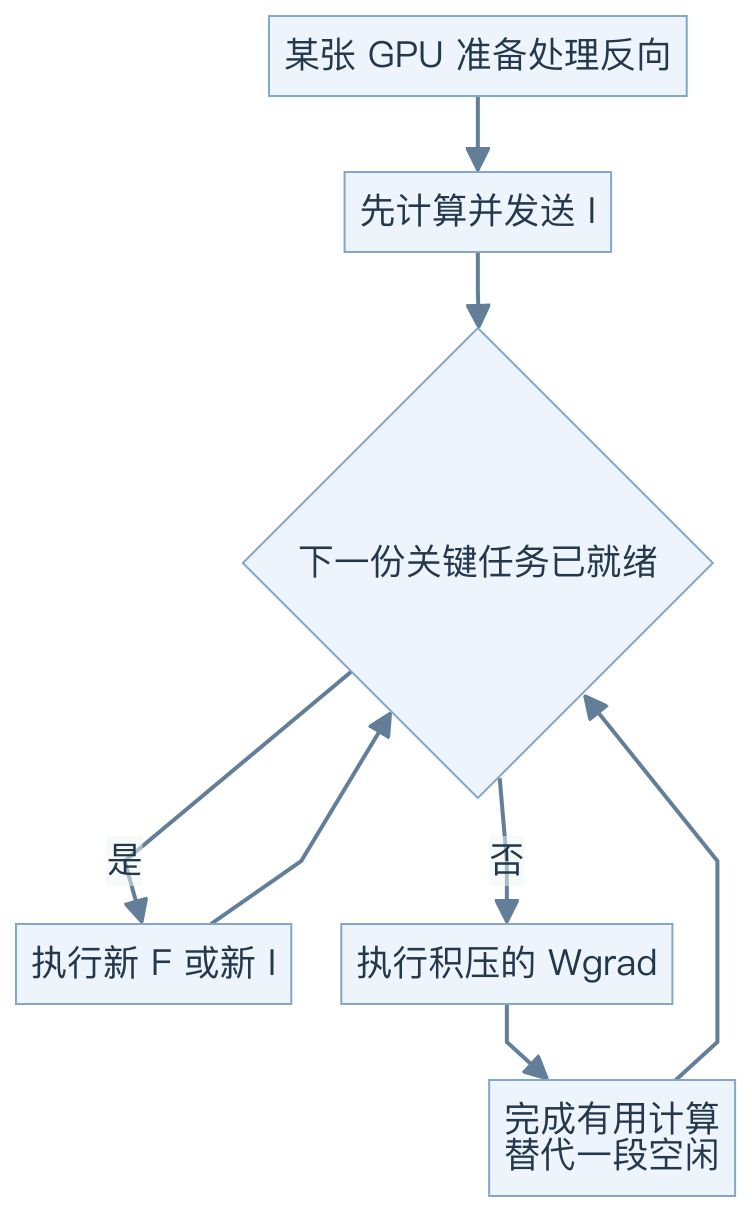
图 15:Wgrad 填充空闲的局部逻辑。完整调度的填充效果取决于 F、I、Wgrad 的具体耗时和依赖。
延后的 Wgrad 仍需完成,也可能要求相关激活或梯度继续驻留。因此,延后计算提高了调度自由度,也会改变显存需求。反向拆分与 Zero Bubble 调度
Zero Bubble 的激活显存与空闲权衡
先把普通 1F1B 的峰值激活显存记为 M。延后 Wgrad 所需保留的输入激活、dY 等动态中间量计入其中;参数、参数梯度累积 buffer 和优化器状态属于其他显存项。
| 调度 | 任务安排 | 峰值激活显存,相对 M | 理论 bubble 时间,相对普通 1F1B |
|---|---|---|---|
| ZB-H1 | 优先 I,使用延后的 Wgrad 填空 | 约 1 倍 | 约 1/3 |
| ZB-H2 | 增加在途前向,进一步重排 Wgrad | 渐近约 2 倍 | 可为 0 |
| ZB-V | V 形布局结合 I 与 Wgrad 分离 | 约 1 倍 | 可为 0 |
| V-Half | 调整 V 形任务间隔,缩短生命周期 | 渐近约 1/2 | 约 1/2 |
| V-Min | 进一步压缩激活驻留 | 渐近约 1/3 | 约 2/3 |
| V-ZB | 可控显存论文中的 V 形零泡构造 | 约 1 倍 | 可为 0 |
表中比例采用论文的均衡简化模型:F、I、Wgrad 各耗时相同,microbatch 足够多,并忽略小常数。ZB-V 和 V-ZB 分别来自不同论文。ZB-H 与 ZB-V、V-Half、V-Min 与 V-ZB
这些方案可以在相同的激活预算下压低 bubble,也可以把一部分调度效率换成更低激活需求。真实负载中的 F、I、Wgrad 耗时各异,某些排程会留下间隙;V-Min 尤其可能在每个重复单元里留下空闲,并随 microbatch 数量累积。
还要处理 optimizer 边界。梯度裁剪要知道全局梯度范数,混合精度训练要检查 NaN 或 Inf,这些全局判断可能重新让 GPU 等待。Zero Bubble 论文使用 optimizer post-validation:先按正常情况推进,再沿流水线完成验证;遇到异常,按规则回滚并重做,以保留同步训练语义。
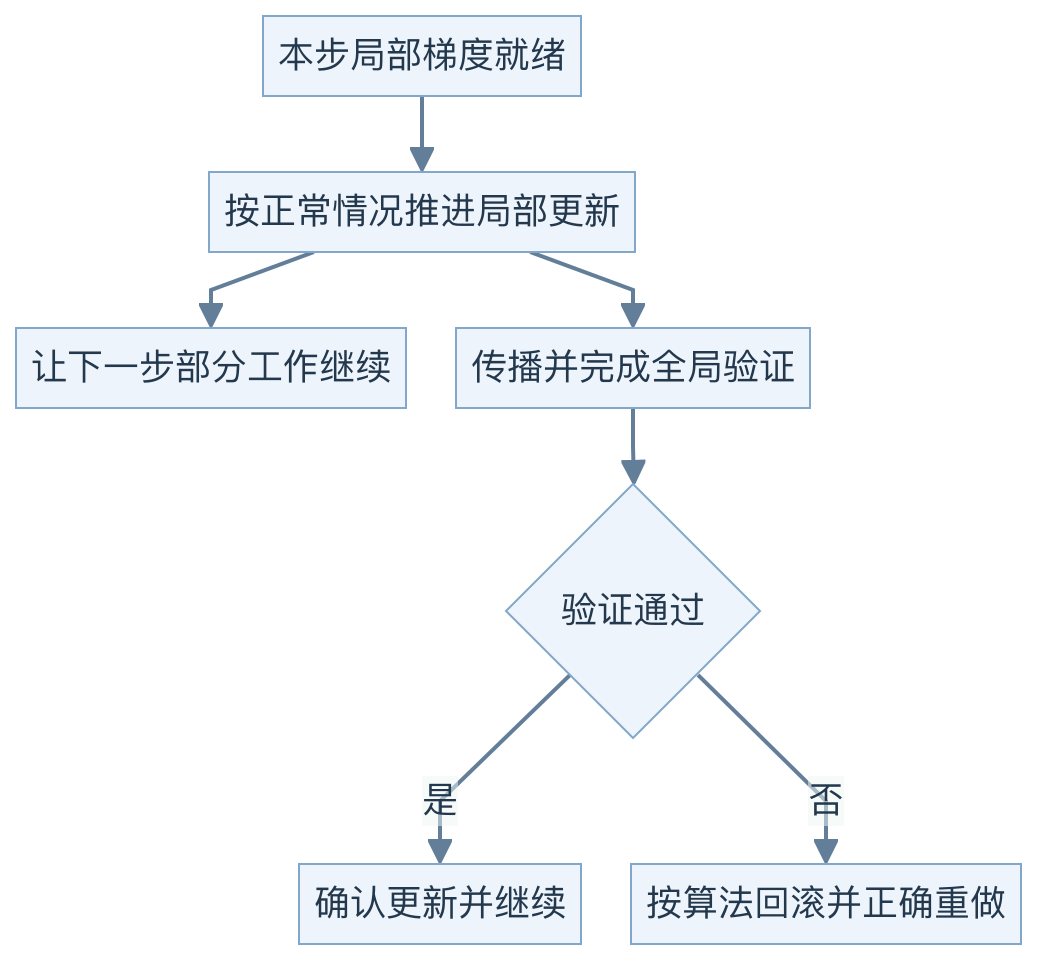
图 16:optimizer post-validation 的概念流程。具体实现需要保证数据、参数和优化器状态的一致性,并在出现异常时执行回滚和重做。更新边界处理
“零 bubble”描述的是特定条件下的稳态调度及迭代边界处理。从所有 GPU 空白启动时,第一份数据仍需逐段传播,形成冷启动时的等待。
双向流水线与通信重叠
Chimera 同时运行两个相反方向的模型流水线。它们从两端输入不同 microbatch,让一个方向空闲时,另一个方向有机会安排工作。经典设计以额外模型副本和副本梯度同步为代价,将 bubble 约减半。Chimera 原论文
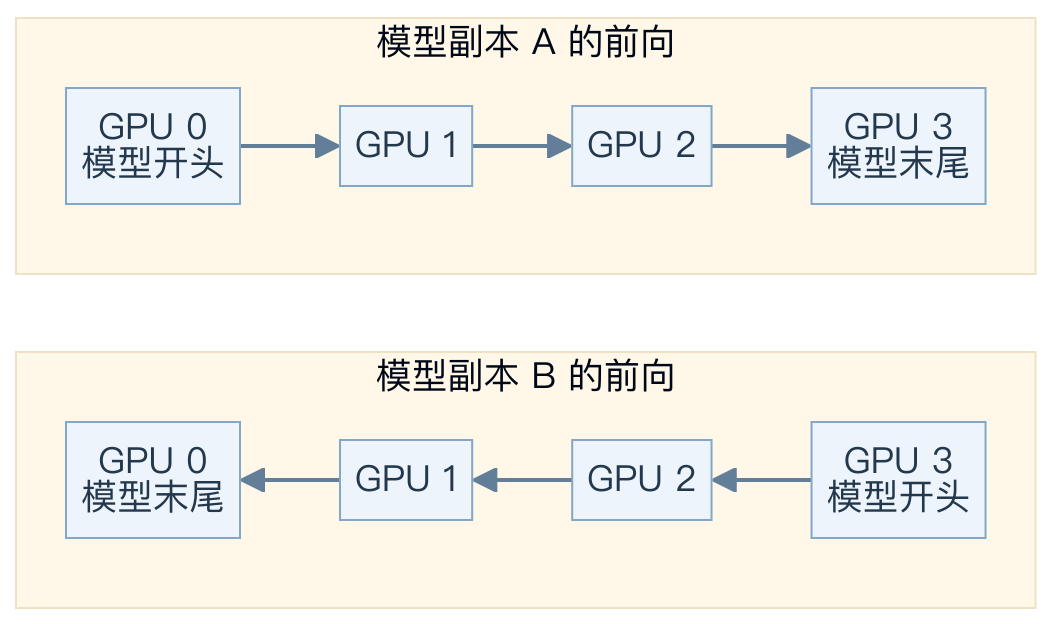
图 17:双向模型放置示意。上下两排分别表示模型副本 A 与 B 的前向路径,同一张 GPU 需要调度两份副本的任务。
DualPipe 在双向调度之外,进一步把前后向内部的 attention、MLP、MoE dispatch 和 combine 等操作交错安排。它利用一份 microbatch 的计算,覆盖另一份 microbatch 的通信,特别针对 MoE 中代价很高的 EP All-to-All。DeepSeek-V3 报告 §3.2.1
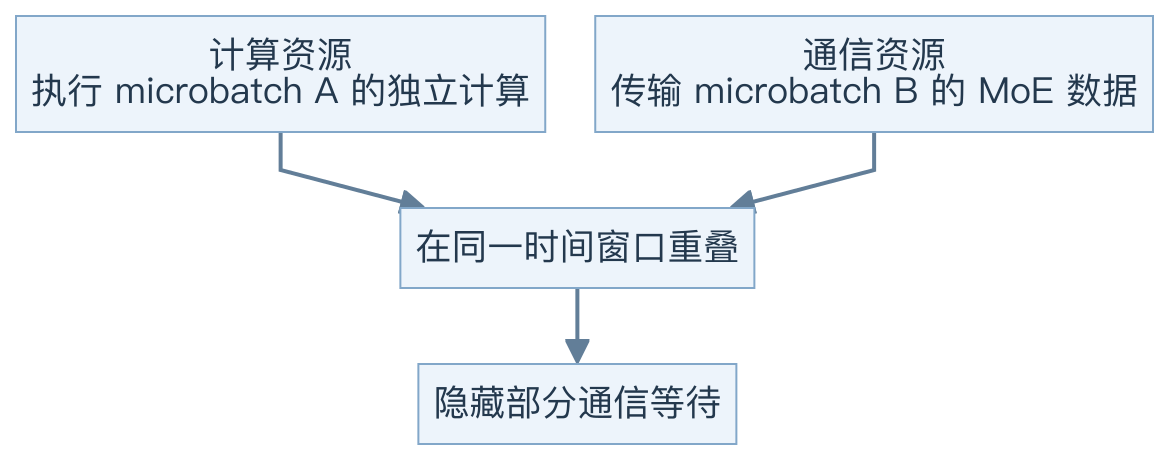
图 18:通信重叠的直觉。计算与通信可在依赖允许、硬件与通信实现支持的情况下重叠,两者的实际耗时可能存在差异。
这里要分清两个收益:改变流水线排程,压缩没有就绪计算任务的空闲;安排计算与通信重叠,减少暴露在关键路径上的传输时间。时间线上看到的空白可能来自不同原因。
DualPipeV 将双向结构折成 V,去除重复模型。固定物理设备数和模型时,经典 DualPipe 参数存储约为普通布局的两倍,DualPipeV 恢复为一份参数的规模,代价之一是 PP 通信量约为普通布局的两倍。比较时需要统一设备数和模型配置。DualPipeV 的作者分析、官方实现
长序列的细粒度调度
Interleaved 沿模型深度把 stage 切小,Seq1F1B 则进一步沿序列把一个 microbatch 切成多个子序列。拆分后,下游可以更早收到部分结果,逐段开始计算。
这个思路利用的是 causal attention。每个 token 可以读取自身及前序位置的 K、V,因此前向子序列有从前往后的依赖,反向有相反方向的依赖。
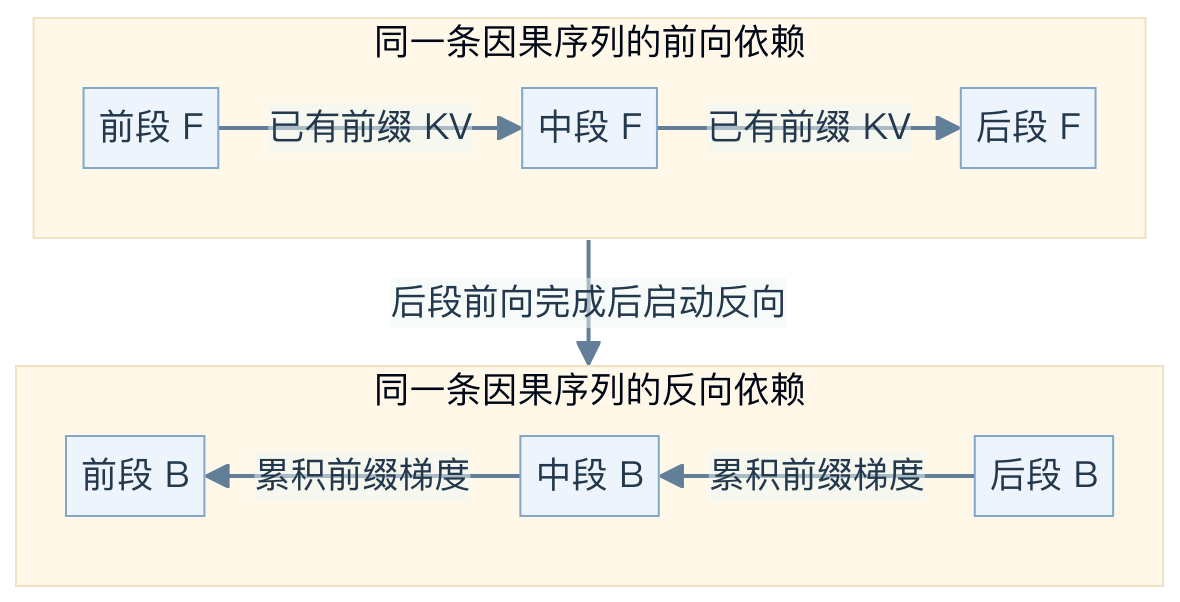
图 19:子序列之间仍有依赖。图示强调方向,完整排程还要同时满足不同 stage、不同 microbatch 的依赖。
Seq1F1B 在原有 PP 设备数基础上增加可调度工作单元。它需要专门的任务队列管理依赖,也要按计算量切分:后段 attention 面对更长前缀,等 token 数通常带来不同的计算量。它还能与 interleaving 或梯度拆分结合。Seq1F1B 方法
对于使用双向全注意力的 DiT,前段 token 也依赖后段 token,序列级调度需要针对这种双向依赖重新设计。
异步 PipeDream、PipeDream-2BW 则走另一条路:允许工作跨参数更新边界持续流动,减少每步 flush,但引入权重版本和梯度延迟。它们改变优化语义,比较时还需关注权重版本和梯度延迟对收敛的影响。
Megatron 中的调度选择与配置
NVIDIA 官方 Megatron-LM 的常规训练主要提供普通同步 1F1B 和 Interleaved 1F1B。后者也叫 VPP,Virtual Pipeline Parallelism,意思是每个物理 PP rank 承担多个虚拟 stage。这里的 V 是 virtual,与前文的 V 形布局 是两回事。
下面限定到所核对的官方代码版本 3d3323fbd。常规入口根据 PP 和 VPP 配置选择调度,MoE 的 Combined 1F1B 则在既有调度内增加通信重叠。调度选择源码
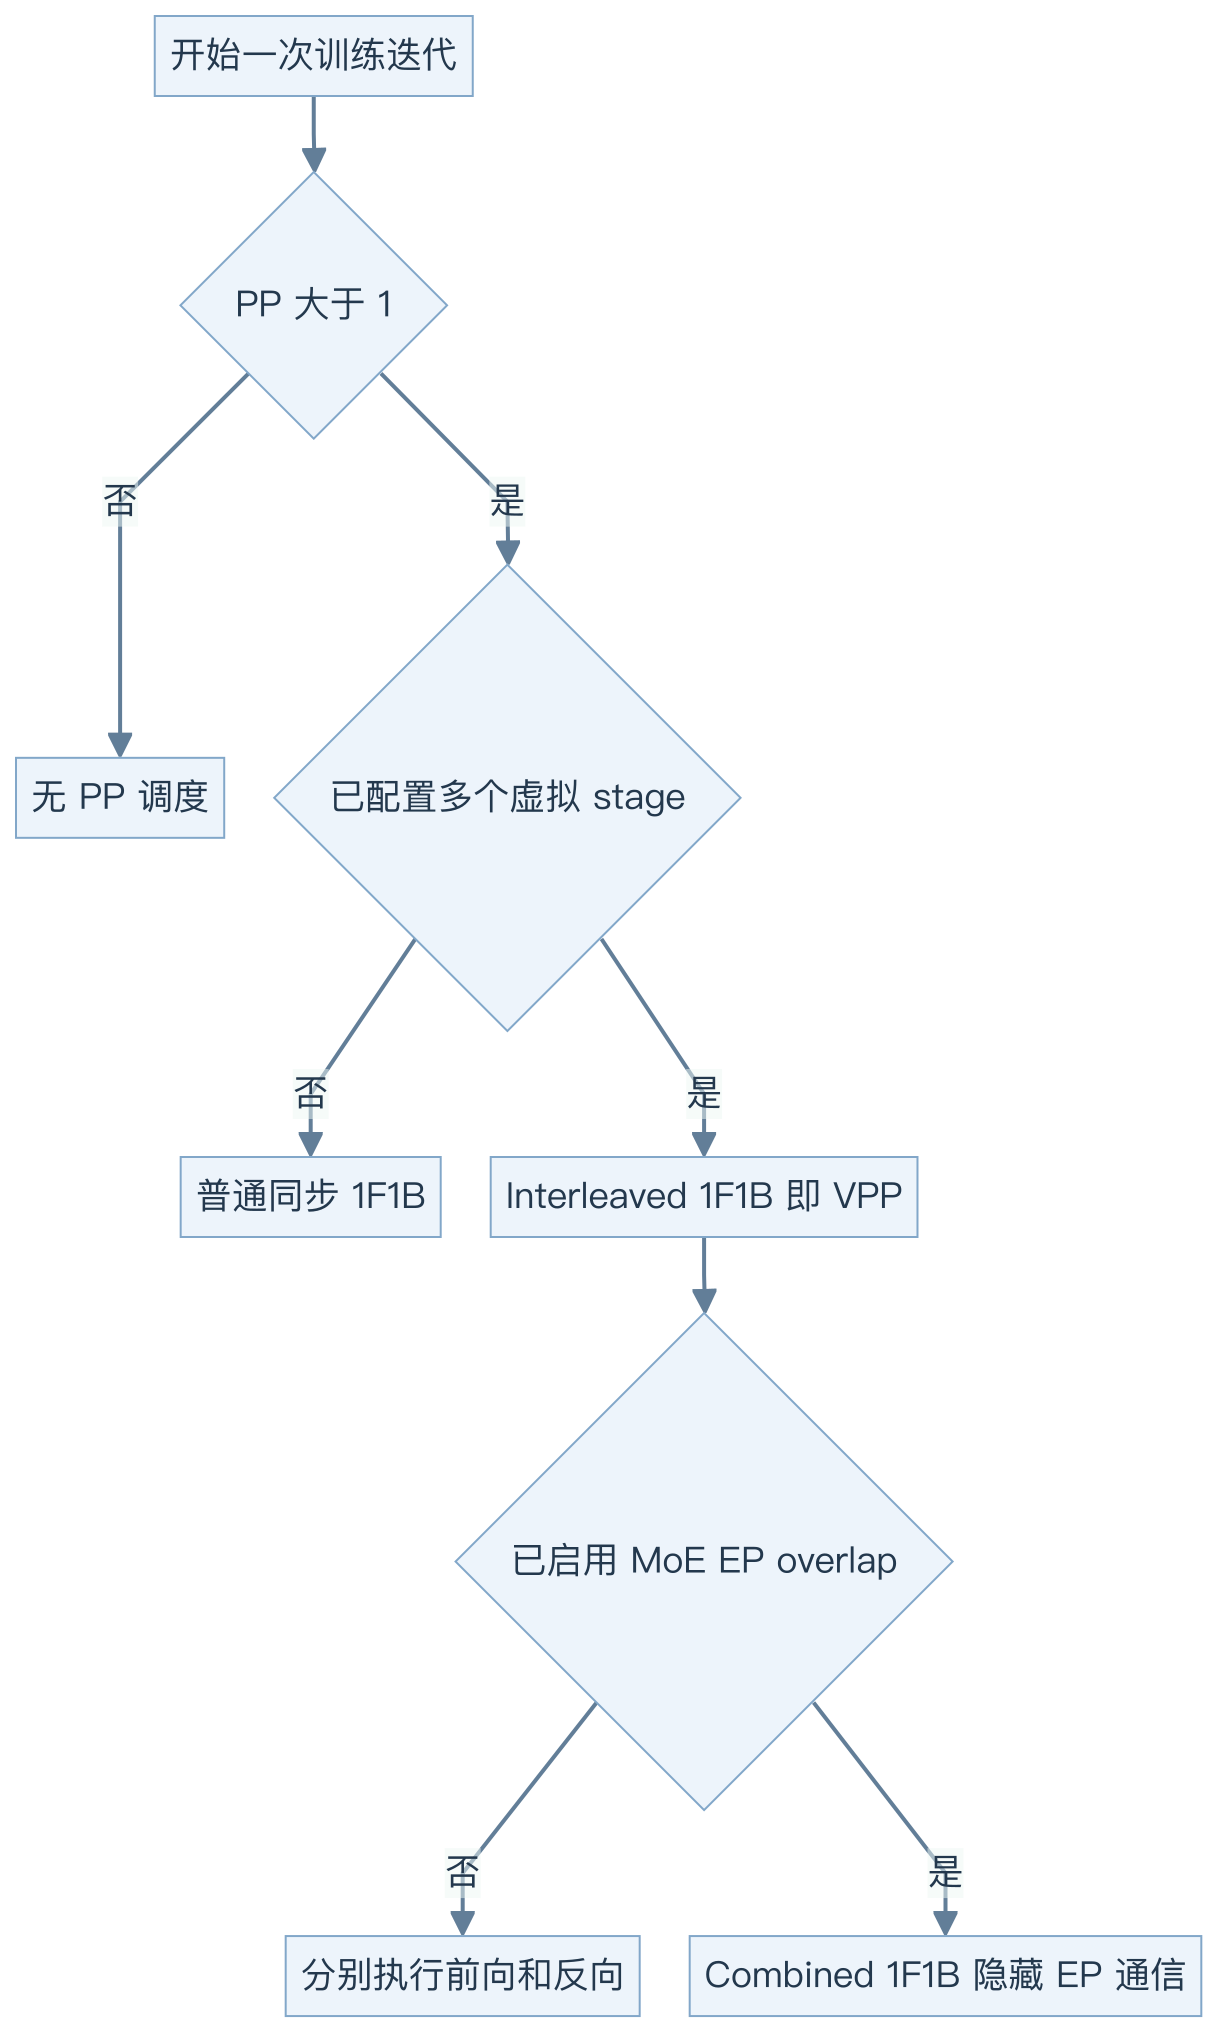
图 20:展示常见单模型 PP 路径;Combined 1F1B 在无 PP 的 MoE 训练中也有入口。
| 调度或优化 | 该版本的支持范围 |
|---|---|
| 普通 1F1B | 原生支持 |
| 1F1B-I、Interleaved、VPP | 原生支持,是同一类调度的不同叫法 |
| MoE Combined 1F1B | 原生支持,用计算覆盖 EP All-to-All 通信 |
| GPipe、1F1B-V、ZB-H1/H2、ZB-V、V-Half/Min | 常规训练入口未提供对应独立调度 |
| DualPipe、DualPipeV、Chimera、Seq1F1B | 常规训练入口未提供对应独立调度 |
部分论文基于 Megatron 提供独立 fork;上表依据所核对的 NVIDIA 官方版本代码。官方 API 对普通和 interleaved 调度的定义与上述源码一致。官方调度文档
从 32 层模型看 PP 和 VPP
先假设 32 个 Transformer 层均匀划分,暂不计 embedding、输出层和 MTP。PP=4 时,每个物理 rank 共承担 8 层;再设 VPP=2,每个 rank 的 8 层拆成两个各含 4 层的 chunk。总共得到 8 个逻辑 stage,但物理 PP rank 仍是 4 个。
下面只列与调度有关的参数,需补入已有的训练命令:
也可以把最后一行替换成 --num-layers-per-virtual-pipeline-stage 4,直接指定每个 chunk 的层数。这两个参数与 --pipeline-model-parallel-layout 互斥,最多指定其中一个。参数互斥检查
microbatch 数另由 batch 配置决定。对于普通等长样本,令 global batch 为 G、DP 副本数为 D、microbatch size 为 b,则每个 PP 副本每步处理的 microbatch 数为 m = G ÷ (D × b)。例如 G=64、D=2、b=4,得到 m=8。PP 和 VPP 将同一批数据经过的模型拆分到多个 stage;m 由 G、D、b 决定,上述例子中 VPP 从 1 改成 2 后,m 仍为 8。
MoE 的 Combined 1F1B 解决通信等待
MoE 场景还可启用:
它将不同 microbatch 的前向、反向内部计算交错安排,以隐藏 EP All-to-All,并延后部分参数梯度计算。该版本要求 EP>1;PP>1 时必须配置 VPP,还受 dispatcher、精度和重计算等条件限制。--delay-wgrad-compute 必须配合 EP overlap 使用。配置检查源码、wgrad 延后条件
另有 defer_embedding_wgrad_compute,专门把 embedding 的参数梯度 GEMM 留到 pipeline flush 时执行。这是针对 embedding 参数梯度的局部填空优化。embedding wgrad 配置说明
从训练时间线找到适合的优化
先根据时间线确定空闲的位置和原因,再选择合适的调度。
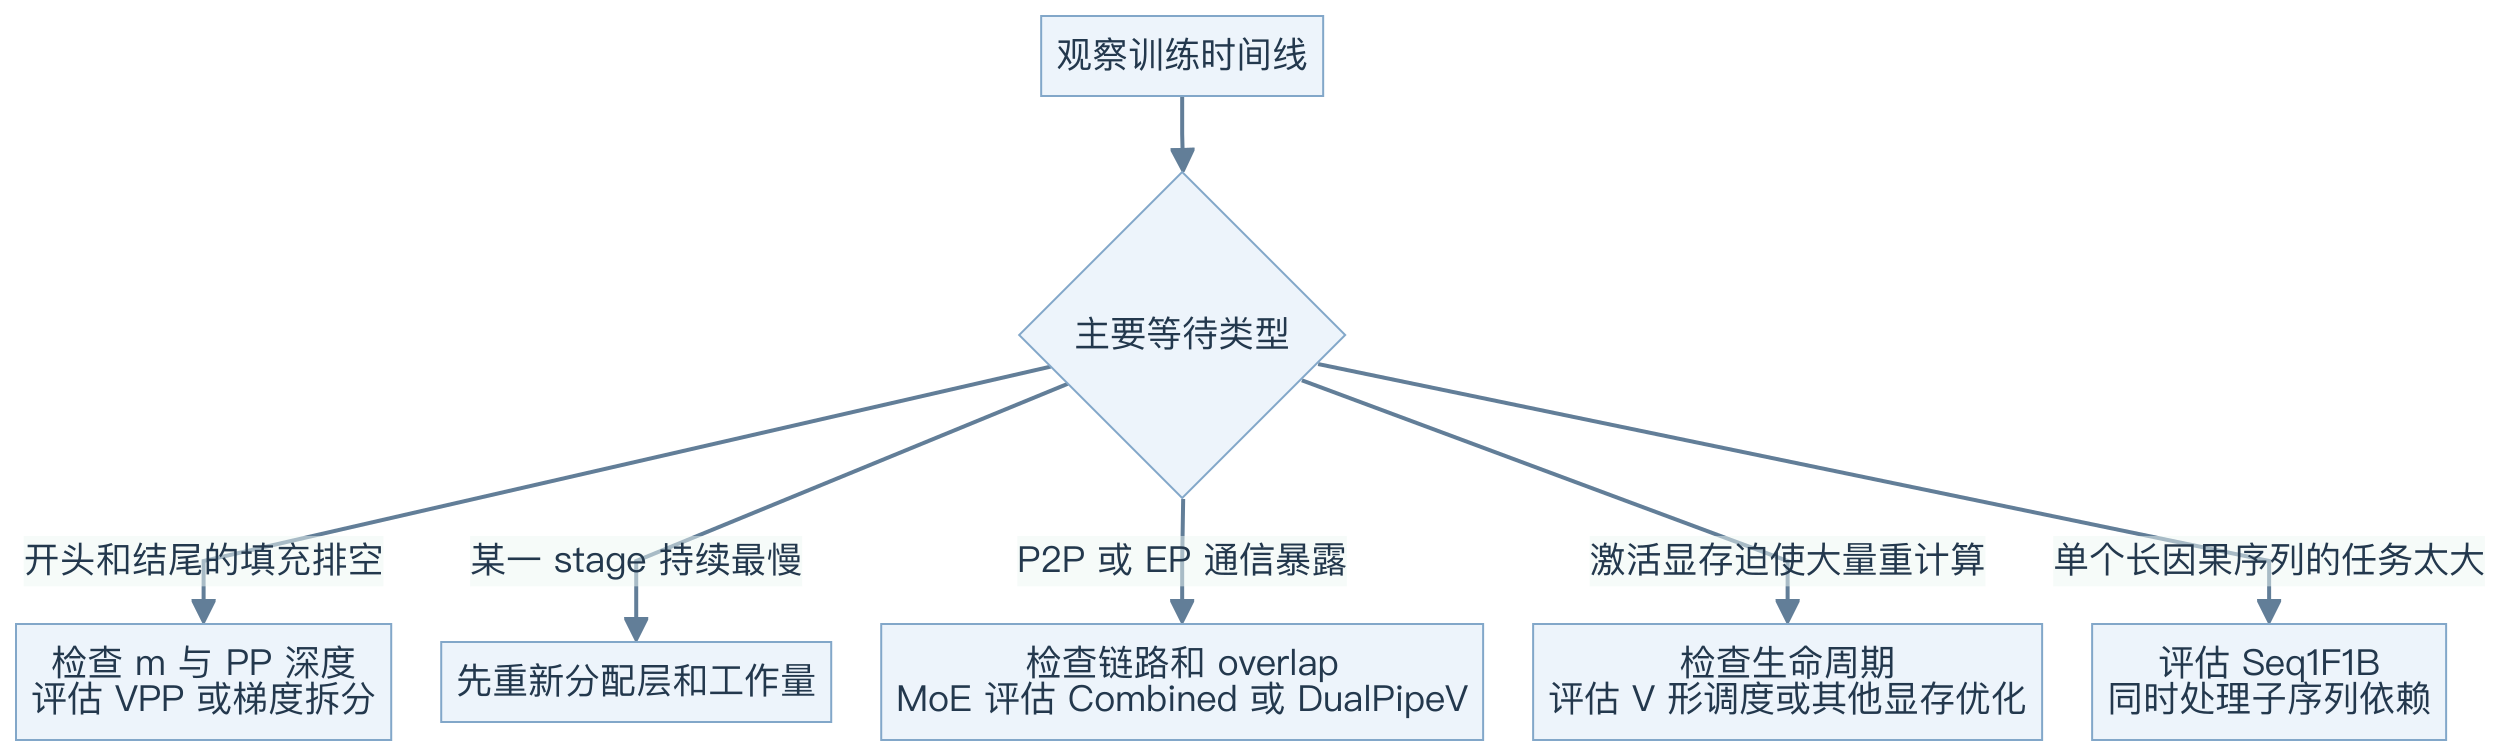
图 21:先区分等待来源。stage 不均衡、通信等待、填充排空和重计算开销可以同时存在。
实际比较应固定模型、global batch、样本或 token 数、设备数量和精度。先记录 step 时间、有效吞吐和峰值显存,再检查时间线上的 P2P、EP 通信、重计算及各 stage 工作量。microbatch size 改变时,单次计算效率也会改变,需要同时记录。
例如,同样把 bubble 从 20% 降到 10%,若新增通信又占了 15% 的时间,整步可能更慢;反过来,一个激活显存更省的方案即使理论 bubble 稍大,也可能因为减少重计算而更快。这些都要以同一负载的端到端结果判断。
分析新的调度时,可以依次梳理 microbatch 的模型路径、每张 GPU 持有的 chunk 或副本、前后向的任务划分与执行约束,以及激活、参数和通信开销。把这些内容画成数据流和时间线,就能看出等待减少的机制及相应成本。
参考资料
Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM,普通及 Interleaved 1F1B、bubble 的分析口径。
Zero Bubble Pipeline Parallelism,反向拆分、ZB-H1/H2、ZB-V、optimizer post-validation。
Pipeline Parallelism with Controllable Memory,生命周期、1F1B-V、V-Min、V-Half、V-ZB。
Chimera,双向同步流水线。
DeepSeek-V3 Technical Report,DualPipe 与 MoE 通信重叠。
DualPipe could be better without the Dual,固定物理设备数的 DualPipeV 比较。
Seq1F1B,因果序列切分及调度。
Megatron Core 官方调度文档与文中固定 commit 的源码链接。
热门文章
近 30 天 · 按去重阅读访问排序
还没有公开留言。欢迎留下第一个问题或复现记录。