传统表达方法
我们以前在图像或者线性代数中经常遇到二维的矩阵。一个行优先的\(2\times 3\)的矩阵,高\(h = 2\), 宽\(w = 3\)。把它放到内存之后,表达形式如下:
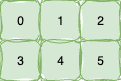
内存都是一维的,上图中的数字其实就是二维矩阵的每个元素在内存中的存储序号,我们后面称它为内存坐标。我们在程序中使用的内存/显存的逻辑地址可以通过内存首地址和内存坐标得到:
一般来说,内存首地址我们很容易得到,它可能是一个数组的首元素地址,或者一个指针指向的地址等。在这种情况下,内存逻辑地址的获取就主要依赖于内存坐标,我们后续的讨论也主要讨论它而不是直接讨论内存逻辑地址。
内存坐标直接和我们数据的排布相关。数据的排布可以使用二维、三维甚至更高维的逻辑坐标表示,我们需要做的就是找到数据逻辑坐标到内存坐标之间的转换公式。
先看一个\(2\times 3\)矩阵的二维逻辑坐标:
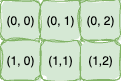
对于上面的矩阵来说,这个转换是我们非常熟悉的,对于逻辑坐标\((r, c)\)(\(r\)表示行序号,\(c\)表示列序号)来说,其内存的物理坐标为
完整的映射关系为:
现在来看列优先的\(2\times 3\)矩阵,其在内存中排布如下:
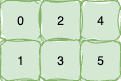
其数据逻辑坐标和行优先的\(2\times 3\)矩阵一样,也就是:
但是映射函数已经不一样了。对于逻辑坐标\((r, c)\)来说,其内存坐标为
完整的映射关系如下:
可以看到,对于同样的\(2\times 3\)的矩阵:
- 行优先(row-major)和列优先(col-major)的改变让我们必须要改变逻辑地址到内存坐标的映射函数,也就是内存坐标和数据排布紧密相关;
- 映射函数始终是逻辑坐标的线性函数。
从上面可以看到,映射函数的系数其实就是矩阵的宽高,但是并不是所有情况下都是这样的。例如在图像处理中,大部分数据都是行优先(row-major)。很常见的一个做法是把一行的数据对齐到\(2^n\)以方便使用SIMD指令进行处理。上面的矩阵进行行数据对齐之后放到内存之后,实际的表现形式是:
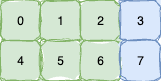
其中内存坐标\(3\)和\(7\)位置的数据是padding数据,而不是矩阵的实际数据。逻辑坐标\((r, c)\)映射到的内存坐标为
矩阵的逻辑坐标和内存坐标完整映射如下:
显然,这时候逻辑坐标到内存坐标的映射仍然是线性组合,只是系数应该使用stride而不是逻辑矩阵的宽高。我们把行坐标每增加1时内存坐标的增量称为行方向stride,它也代表了第\(i\)行和第\(i+1\)行同一列的数据的内存坐标差值。例如上图,行方向stride等于4,因为第1行的第一个元素(0)到第2行的第一个元素(4)的内存地址差值等于4。同理,列坐标每增加1时内存坐标的增量称为列方向stride,它代表同一行里面两列数据之间内存坐标的差值。
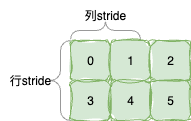
row-major排列的数据在没有padding的情况下,行stride和\(w\)相等;列stride等于1;col-major的数据在没有padding的情况下,行stride等于1,列stride等于h。也就是说,逻辑坐标到内存坐标的映射系数应该是行列stride而非宽高,使用宽高只是因为在特定情况下行列stride和宽高刚好相等。
上面所有的情况,我们其实可以使用一个统一的表达形式:\((r, c): (\mathrm{stride}_r, \mathrm{stride}_c)\)来表示。例如上面的三种情况:
- row-major:\((2,3):(3, 1)\)
- col-major:\((2, 3):(1, 2)\)
- row-major-padded: \((2, 3):(4, 1)\)
在任何一种情况下,一个逻辑坐标\((r, c)\)都是映射到内存坐标\(r * \mathrm{stride}_r + c * \mathrm{stride}_c\)。
使用shape: stride的模式,我们可以完整覆盖传统的行优先、列优先以及添加padding的情况。
shape:stride覆盖更加复杂的表达
矩阵乘法中经常使用的模式:
- 把矩阵A和B进行分块;
- 计算各个块之间的矩阵乘法;
- 把相关的块的矩阵乘法结果相加得到最终的结果。
里面很关键的一个操作就是把矩阵进行分块。我们现在来看一个\(4\times 6\)的分块矩阵:
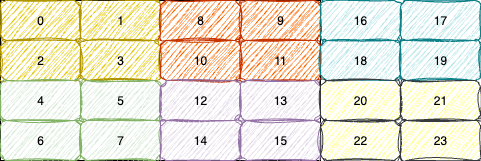
这个矩阵是把一个\(4\times 6\)矩阵分成\(2\times 2\)的块。很显然,我们无法利用行优先、列优先以及添加padding中任何一种来表达。对它进行拆解,大的矩阵其实是一个\(2\times 3\)的矩阵,这个矩阵的每个元素是一个\(2 \times 2\)的矩阵。对于外层的这个矩阵来说,使用上面的统一表达形式可以表达为\((2, 3): (4, 8)\)。内层的\(2\times 2\)矩阵可以表达为\((2, 2):(2, 1)\)。
我们把上面的内外层矩阵按照\(((\text{内层行},\text{外层行}),(\text{内层列},\text{外层列})):((\text{内层行stride},\text{外层行stride}),(\text{内层列stride},\text{外层列stride}))\)进行排列,可以得到
对于任意一个逻辑坐标\(((r_0, r_1), (c_0, c_1))\),其中\((r_0, c_0)\)是内层矩阵的行列坐标,\((r_1, c_1)\)是外层的行列坐标,我们可以得到内存坐标为
例如按0起始编号,外层坐标为\((1,1)\)、内层坐标为\((0,1)\),那么逻辑坐标为\(((0, 1),(1, 1))\),内存坐标为13。对照上图,我们会发现这个内存地址是完全正确的。
当然了,我们也可以按照更加习惯的方式,按照\(((\text{内层行},\text{内层列}),(\text{外层行},\text{外层列})):((\text{内层行stride},\text{内层列stride}),(\text{外层行stride},\text{外层列stride}))\)的方式进行排布,得到
对于逻辑坐标\(((r_0, c_0), (r_1, c_1))\),其到内存坐标的映射依然是
可以看到,无论哪种表达形式,只要保证给定的坐标顺序满足排布的顺序,并不会影响内存坐标的计算。
这种表达还有另外一个好处,我们给定一个外层的坐标\((i, j)\),可以选择内层的子矩阵:
例如
至此,我们可以看到,shape:stride模式不但可以表达传统行优先、列优先可以表达的模式,还可以表达更加复杂的排布模式。这就是我们为什么要使用这总表达来表达数据排布,以及研究这种表达的各种性质的原因。
最后,还可以看一些更多的例子。
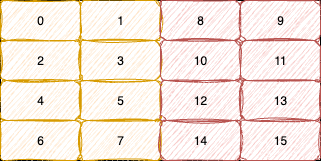
上面可以表示为\((4, (2, 2)):(2, (1, 8))\)(里面涉及到省略1,后续文章再分析)。
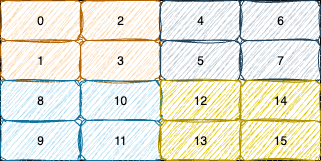
上图可以表达为\(((2, 2), (2, 2)): ((1, 8), (2, 4))\)。